Data warehouse, data lake y lakehouse: cuándo una pyme los necesita
Respuesta corta
Un data warehouse es un almacén de datos estructurados, organizados para consultas e informes de negocio, con un esquema definido antes de cargar la información. Un data lake guarda datos en bruto de cualquier tipo y da forma a los datos al momento de leerlos. Un lakehouse intenta combinar ambos enfoques sobre almacenamiento abierto. Una pyme suele necesitar un data warehouse cuando reúne datos de varios sistemas y los reportes manuales ya no alcanzan; antes de eso, una base de datos bien diseñada y un buen tablero bastan.
Puntos clave
- Un data warehouse guarda datos estructurados con un esquema definido, pensado para consultas analíticas.
- Un data lake guarda datos en bruto de cualquier formato; da flexibilidad, pero exige orden para no volverse inservible.
- Un lakehouse busca unir ambas ideas en almacenamiento abierto. Es una arquitectura, no un producto único.
- ETL transforma los datos antes de cargarlos; ELT los carga primero y los transforma dentro del almacén.
- Una pyme necesita un almacén cuando combina datos de varios sistemas y sus reportes consumen horas de trabajo manual.
- El costo depende del volumen, de las consultas y del personal que mantiene los procesos, no solo de la licencia.
¿Qué es un data warehouse?
Un data warehouse es un repositorio central de datos, sobre todo estructurados e históricos, organizado para responder preguntas de negocio mediante consultas e informes. Sus datos llegan desde sistemas operativos como un ERP, un sistema de reservas o un CRM, y se modelan para que la gerencia y los analistas puedan cruzarlos sin consultar directamente esos sistemas.
La documentación oficial de los servicios gestionados describe bien esta idea. Según la documentación de Google Cloud, BigQuery es un almacén analítico totalmente gestionado, con una capa de almacenamiento que ingiere y optimiza los datos y una capa de cómputo que ejecuta los análisis. Según la documentación de AWS, Amazon Redshift es un servicio de almacenamiento de datos gestionado pensado para grandes volúmenes que funciona con herramientas de inteligencia de negocios. Ambos son ejemplos de un data warehouse en la nube, aunque no son la única forma de tenerlo.
El punto clave es el esquema. En un data warehouse, la estructura de las tablas se define antes de cargar los datos, lo que facilita los informes repetibles pero exige decidir de antemano qué preguntas se van a responder.
La siguiente figura muestra el recorrido completo de los datos en una arquitectura de este tipo, desde los sistemas de origen hasta los tableros, con el gobierno como capa transversal.
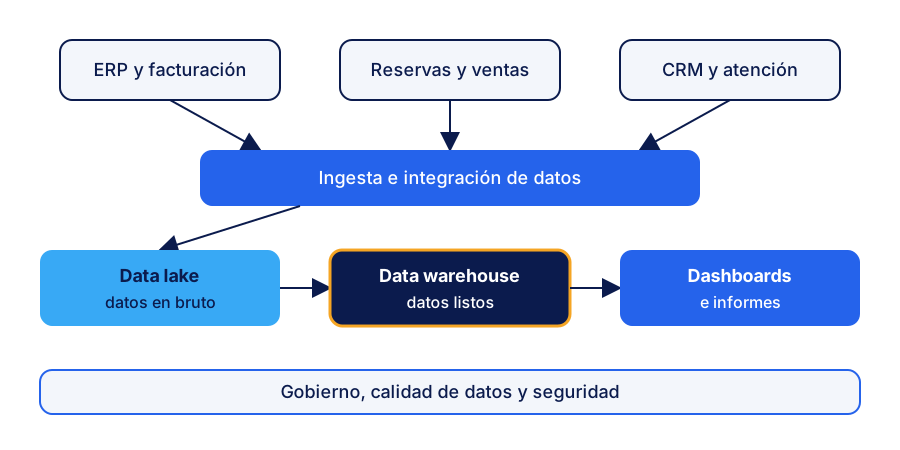
Figura 1. Arquitectura de datos de extremo a extremo: los datos llegan desde los sistemas, pasan por un lago o almacén y terminan en informes; el gobierno acompaña todo el recorrido.
Data lake: guardar primero y entender después
Un data lake es un repositorio que almacena datos en su formato original: archivos CSV, registros JSON, bitácoras de sistemas, imágenes o documentos. No obliga a definir un esquema al escribir. Ese esquema se aplica cuando alguien lee los datos.
Esa flexibilidad tiene una ventaja clara: el almacenamiento es barato en comparación con la complejidad de modelar todo de antemano, y se puede guardar información que todavía no tiene un uso definido. Pero tiene un riesgo conocido. Sin catálogo, sin dueños de los datos y sin control de calidad, el lago se llena de archivos duplicados, desactualizados o incomprensibles. En la industria se le suele llamar “pantano de datos” (data swamp).
Para una pyme, un data lake solo se justifica si hay material no estructurado o de sensores que se necesita analizar, o si ya existe un equipo técnico capaz de mantenerlo.
Lakehouse: la tendencia de unir ambos mundos
El lakehouse surgió como respuesta a una arquitectura de dos niveles. En ese modelo, los datos se guardan primero en un lago y después se copian a un almacén para el análisis, con procesos adicionales en cada paso.
El artículo Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics, de Michael Armbrust, Ali Ghodsi, Reynold Xin y Matei Zaharia, presentado en la conferencia CIDR en 2021, describe esa propuesta: ofrecer funciones de almacén de datos sobre almacenamiento abierto, como el formato Apache Parquet. Los autores informan de un prototipo que compite con almacenes en la nube en el benchmark TPC-DS. Es un resultado de investigación, no una garantía para cualquier caso.
En la práctica, un lakehouse se implementa con servicios concretos. La guía de decisión de Microsoft Learn para Microsoft Fabric plantea la elección entre lakehouse y warehouse según el lenguaje que usa el equipo (Spark para un lakehouse, T-SQL para un warehouse), si se necesitan transacciones que afecten varias tablas y qué tipo de datos existen. Según esa guía, los datos exclusivamente estructurados apuntan a un warehouse y los datos mixtos o sin definir apuntan a un lakehouse.
Diferencias entre data warehouse, data lake y lakehouse
La siguiente tabla resume las diferencias de forma general. La columna de criterio indica en qué se basa cada afirmación.
| Criterio | Data warehouse | Data lake | Lakehouse |
|---|---|---|---|
| Tipo de datos | Principalmente estructurados | Cualquier formato | Cualquier formato, con capa de tablas |
| Cuándo se define el esquema | Antes de cargar (esquema al escribir) | Al leer (esquema al leer) | Según la capa de uso |
| Usuario típico | Analistas y gerencia, con SQL y BI | Ingenieros y científicos de datos | Equipos mixtos |
| Riesgo principal | Rigidez ante cambios frecuentes | Convertirse en pantano sin catálogo | Complejidad de diseño |
| Criterio de la fuente | Documentación de BigQuery y Redshift | Artículo CIDR 2021 | Guía de decisión de Microsoft Fabric |
Esta tabla es una síntesis de elaboración propia a partir de las fuentes citadas, no una clasificación oficial de los proveedores.
ETL y ELT: dónde se transforma el dato
Antes de elegir una arquitectura conviene entender cómo llegan los datos. Hay dos enfoques principales.
En ETL (extraer, transformar y cargar), los datos se extraen de los sistemas, se limpian y se transforman fuera del almacén, y solo después se cargan. Da más control sobre lo que entra, pero el proceso intermedio suele ser más difícil de cambiar.
En ELT (extraer, cargar y transformar), los datos se cargan en bruto y las transformaciones se ejecutan dentro del almacén. La guía de Snowflake sobre ETL y ELT indica que ELT es más común para consolidar datos en un almacén en la nube, porque estas plataformas pueden procesar a escala. Según la misma guía, ELT permite cambiar la lógica de transformación sin reconstruir toda la carga: se modifica el modelo SQL y se vuelve a ejecutar sobre los datos ya cargados.
Las dos opciones no son excluyentes. Para una pyme, lo importante es que cada transformación tenga un responsable y quede documentada, sin importar dónde ocurra.
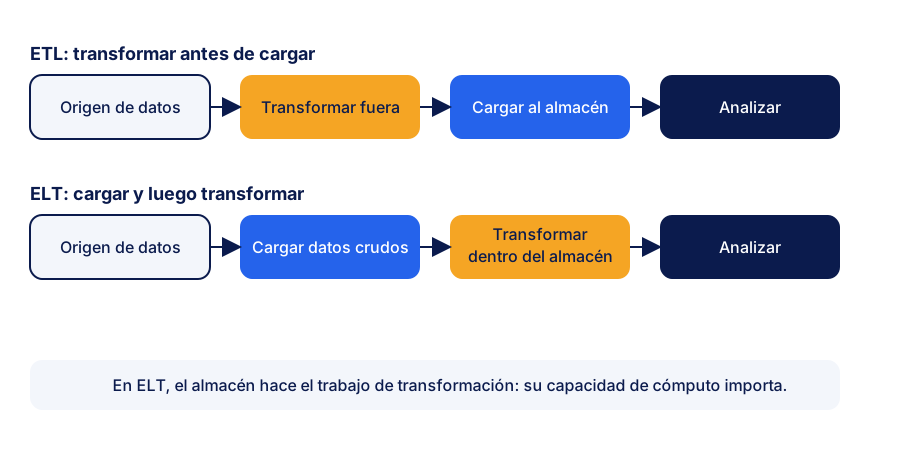
Figura 2. Comparación de ETL y ELT: en ETL la transformación ocurre antes de la carga; en ELT, dentro del almacén.
Cuándo basta una base de datos normal
Mucha información de una pyme vive en una sola base de datos operativa: el sistema de facturación, la plataforma de reservas o el software de inventario. Si los reportes salen de un solo sistema, se consultan pocas veces al día y no afectan la operación, una base de datos bien diseñada con vistas o consultas programadas es suficiente. Un buen tablero de indicadores también puede bastar. Si todavía evalúas qué tipo de base de datos conviene, el artículo sobre SQL vs NoSQL: cómo elegir la base de datos de tu sistema ayuda a decidir ese punto. Para definir qué medir antes de invertir en infraestructura, el artículo sobre inteligencia de negocios: qué datos medir en tu empresa es un buen punto de partida.
El error más común es invertir en un almacén para resolver un problema que en realidad es de definiciones. Si ventas, facturación y reservas cuentan “cliente” de tres formas distintas, un almacén solo guardará las tres versiones con más eficiencia.
Cuándo una pyme necesita un almacén
Un data warehouse empieza a tener sentido cuando aparecen varios síntomas a la vez. La siguiente tabla resume las señales más frecuentes y qué conviene hacer primero.
| Señal | Qué significa | Qué hacer primero |
|---|---|---|
| Datos de tres o más sistemas que no se cruzan | Hay que integrar antes de analizar | Revisar la integración de sistemas |
| Reportes armados a mano cada semana | Horas de trabajo y riesgo de error | Definir las métricas y su fórmula |
| Consultas pesadas que frenan el sistema operativo | El análisis compite con la operación | Separar la lectura de la base operativa |
| Necesidad de historial de varios años | El sistema operativo no conserva ese detalle | Diseñar una política de retención |
| Decisiones de precios o campañas sin cifras confiables | Falta calidad y gobierno de datos | Asignar dueños y controles de calidad |
Para elegir la arquitectura según el caso, la siguiente tabla sirve como guía inicial.
| Situación | Opción sugerida | Motivo |
|---|---|---|
| Un sistema principal y reportes sencillos | Base de datos con vistas y tablero | Menor complejidad y mantenimiento |
| Varias fuentes estructuradas y equipo que usa SQL | Data warehouse gestionado | Consultas e informes sobre datos integrados |
| Datos estructurados junto a archivos, bitácoras o imágenes | Lakehouse o data lake | Soporta formatos mixtos |
| Sin personal técnico ni responsable de datos | Empezar por integración y métricas | Un almacén sin dueño se vuelve costoso |
Servicios gestionados: qué revisar antes de elegir
Los proveedores principales ofrecen almacenes gestionados. Conviene revisar la documentación oficial antes de decidir:
- BigQuery (Google Cloud): según su documentación, ofrece modos de precio bajo demanda y tarifa plana, y funciones integradas de gobierno y calidad de metadatos.
- Amazon Redshift (AWS): según su documentación, está orientado a grandes volúmenes y puede usarse en modo sin servidor o con clústeres aprovisionados.
- Microsoft Fabric (Microsoft): ofrece lakehouse y warehouse sobre un almacenamiento compartido. La guía de decisión de Microsoft Learn ayuda a elegir entre ambos.
- Snowflake: según su guía, es una plataforma de datos en la nube que admite ETL y ELT y se integra con herramientas especializadas de integración. No es, por sí misma, una herramienta de ETL.
No hay datos públicos verificados para Perú sobre precios de estos servicios en soles, y las tarifas cambian con el tiempo. Por eso, al pedir una propuesta, conviene exigir un cálculo que indique el volumen de almacenamiento, el número de consultas y las horas de mantenimiento previstas.
Costos como estructura
El costo de un almacén de datos no se reduce a la licencia o a la cuota mensual. Tiene cuatro componentes principales:
- Almacenamiento: el volumen de datos conservados, con su historial.
- Cómputo: el procesamiento de transformaciones y consultas, que sube con el uso de tableros y reportes.
- Integración: los conectores o procesos que extraen datos de cada sistema, y que se rompen cuando cambia un sistema origen. Muchos de ellos se apoyan en APIs y webhooks, por lo que conviene revisar esa base antes de presupuestar.
- Personal y mantenimiento: alguien debe definir modelos, revisar calidad y atender incidencias.
Un proyecto que solo presupuesta el primer componente suele quedarse corto. Una forma prudente de empezar es un piloto con dos o tres fuentes y un conjunto acotado de indicadores, midiendo el consumo real antes de ampliar el alcance.
Gobierno de datos y calidad
Un almacén sin gobierno se convierte en una colección de tablas que nadie confía. Tres prácticas básicas reducen ese riesgo:
- Definiciones compartidas: una métrica como “venta” tiene una sola fórmula, documentada y aprobada por el área responsable.
- Dueños de datos: cada fuente y cada tabla importante tiene una persona responsable de su calidad.
- Controles automáticos: validaciones simples, como que no haya fechas futuras en una factura o que los identificadores de cliente no estén vacíos.
La documentación de BigQuery menciona funciones integradas de gobierno que cubren metadatos y calidad de datos. Esas herramientas ayudan, pero no reemplazan la decisión humana sobre qué significa cada dato.
Datos personales: una exigencia que no se puede posponer
Un almacén de datos concentra información de clientes, pacientes, pasajeros o empleados: nombres, documentos de identidad, correos y montos de compra. Por eso la seguridad y el uso de esos datos forman parte del diseño, no de una etapa posterior.
La Ley 29733, de protección de datos personales en el Perú, exige, entre otras cosas, usar los datos para la finalidad informada y aplicar medidas de seguridad. Antes de centralizar datos personales, conviene revisar qué información es realmente necesaria, quién puede consultarla y cuánto tiempo se conserva. Un almacén también debe incluirse en la estrategia de respaldo; el artículo sobre backup empresarial explica cómo proteger la información que concentra. El detalle de obligaciones está en el artículo sobre la ley de protección de datos personales en el Perú y lo que debe cumplir tu empresa.
Errores comunes
- Comprar un almacén antes de definir las preguntas de negocio. Sin preguntas claras, el resultado es un repositorio grande y poco usado.
- Llenar un lago sin catálogo. Guardar todo sin documentar lo que contiene produce un pantano de datos.
- Dejar que cada área defina las métricas a su manera. Las diferencias aparecen en la reunión de gerencia, no en el almacén.
- Subestimar el mantenimiento de las integraciones. Cada cambio en un sistema origen puede romper una carga.
- Dar acceso amplio a datos personales. Un almacén centralizado facilita la consulta, y también la fuga de información.
- Confiar en el tablero sin revisar la fuente. Un gráfico bonito puede estar construido sobre datos incompletos.
Preguntas frecuentes
¿Qué diferencia hay entre un data warehouse y una base de datos normal?
Una base de datos operativa registra transacciones del día a día, como ventas o reservas. Un data warehouse reúne datos de varias fuentes, con historial, y está optimizado para consultas analíticas que no deben frenar la operación.
¿Cuánto cuesta un data warehouse para una pyme en Perú?
No hay datos públicos verificados para Perú sobre precios de estos servicios. El costo depende del volumen de datos, de las consultas, de las integraciones y del personal que lo mantiene, por lo que conviene pedir una propuesta con supuestos explícitos.
¿Mi pyme necesita un data lake?
Por lo general, no al inicio. Un data lake se justifica cuando hay archivos, bitácoras o datos no estructurados que se quieren analizar y existe un equipo técnico que pueda mantenerlo con orden.
¿Es mejor ETL o ELT?
Depende de dónde se quiera controlar la transformación y de la capacidad del almacén. ELT suele usarse con almacenes en la nube que procesan a escala, mientras que ETL da más control antes de que los datos entren.
¿Un lakehouse reemplaza al data warehouse?
No necesariamente. Un lakehouse combina funciones de ambos enfoques sobre almacenamiento abierto, pero la elección depende del tipo de datos, del lenguaje del equipo y de las transacciones que se necesitan.
¿Puedo empezar sin un almacén de datos?
Sí. Muchas pyme empiezan definiendo métricas, ordenando sus datos en una base operativa y automatizando algunos reportes. Cuando las preguntas crecen y cruzan varias fuentes, el almacén se vuelve una decisión más clara.
Glosario rápido
Data warehouse: almacén central de datos estructurados e históricos, organizado para consultas e informes.
Data lake: repositorio que guarda datos en bruto de cualquier formato, con el esquema aplicado al leer.
Lakehouse: arquitectura que busca ofrecer funciones de almacén sobre almacenamiento abierto de tipo lago.
ETL: proceso que extrae, transforma y luego carga los datos.
ELT: proceso que extrae, carga los datos en bruto y transforma dentro del almacén.
Esquema: estructura que define tablas, columnas y tipos de datos.
Gobierno de datos: conjunto de reglas, responsables y controles que mantienen los datos confiables y seguros.
Pantano de datos: lago de datos sin catálogo ni calidad, difícil de usar.
Si tu empresa ya tiene datos dispersos en varios sistemas y quiere evaluar una arquitectura, puedes escribirnos desde la página de contacto. Para entender cómo se conectan las plataformas que alimentarían ese almacén, revisa nuestro servicio de desarrollo de plataformas.
Última revisión: 14 de noviembre de 2026.
Fuentes y lecturas recomendadas
- Google Cloud, BigQuery overview. https://docs.cloud.google.com/bigquery/docs/introduction
- Amazon Web Services, Amazon Redshift Documentation. https://docs.aws.amazon.com/redshift/
- Microsoft Learn, Microsoft Fabric decision guide: Choose between Warehouse and Lakehouse. https://learn.microsoft.com/en-us/fabric/get-started/decision-guide-lakehouse-warehouse
- Armbrust, M.; Ghodsi, A.; Xin, R.; Zaharia, M., Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics, CIDR, 2021. https://vldb.org/cidrdb/2021/lakehouse-a-new-generation-of-open-platforms-that-unify-data-warehousing-and-advanced-analytics.html
- Snowflake, ETL vs. ELT. https://snowflake.com/guides/etl-vs-elt
- Congreso de la República del Perú, Ley 29733, Ley de Protección de Datos Personales. Solo se menciona en términos generales (finalidad y seguridad); revisar el texto vigente antes de tomar decisiones legales.
Desarrollo de software a medida
Plataformas web y apps que digitalizan y automatizan procesos de tu empresa.