Chatbots con IA y RAG: cómo responder con la información de tu empresa
Respuesta corta
Un chatbot con inteligencia artificial basado en RAG primero busca en los documentos de la empresa los fragmentos relacionados con la pregunta y después pide a un modelo de lenguaje que redacte la respuesta usando esos fragmentos. Así puede responder con información propia y actualizada sin reentrenar el modelo. RAG reduce las respuestas inventadas, pero no las elimina, por lo que necesita documentos ordenados, permisos por usuario y evaluaciones periódicas.
Puntos clave
- RAG separa dos tareas: encontrar la información relevante y redactar la respuesta.
- La calidad del chatbot depende tanto de los documentos como del modelo.
- Los permisos deben aplicarse antes de recuperar la información, no solo en la pantalla.
- RAG reduce las alucinaciones, pero no las elimina: la respuesta debe citar su fuente.
- La calidad se mide con preguntas reales de clientes o empleados y respuestas revisadas.
- El costo incluye preparar documentos, búsqueda, consumo del modelo y mantenimiento del contenido.
El problema: un bot que no conoce tu empresa
Un chatbot general puede explicar conceptos, pero no conoce tus tarifas vigentes, tus políticas de cambio o los horarios de tu oficina en Cusco. Cuando un cliente pregunta por esos temas, el bot puede responder algo plausible pero incorrecto, y el equipo termina contestando lo mismo una y otra vez.
Una agencia de turismo, por ejemplo, recibe consultas sobre condiciones de cancelación, rutas o qué incluye cada tour. Si el bot responde con datos de otra empresa o inventa una política, el daño es comercial y de confianza. Por eso el reto no es solo tener un chatbot, sino darle acceso a la información correcta, solo a la que corresponde y con la capacidad de decir cuándo no sabe.
Para ver casos de uso en un sector específico, el artículo sobre chatbots para agencias de turismo y atención automática 24/7 muestra escenarios concretos.
¿Qué es RAG?
RAG es un patrón de diseño en el que un modelo de lenguaje consulta una fuente de información externa antes de generar su respuesta. El nombre viene de sus siglas en inglés, retrieval-augmented generation, que en español se traduce como generación aumentada por recuperación.
La idea tiene origen académico. El artículo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de Patrick Lewis y otros coautores, publicado en arXiv en 2020, combina una memoria paramétrica (el modelo generador preentrenado) con una memoria no paramétrica (un índice de documentos que se consulta durante la respuesta). Los autores señalan que, al cambiar el índice, puede actualizarse el conocimiento del modelo sin reentrenarlo por completo.
La documentación de Microsoft describe la misma lógica en términos prácticos: RAG agrega un paso de recuperación de información a un modelo de chat para que sus respuestas se apoyen en contenido empresarial. Ese paso de recuperación es la pieza que más cuidado requiere.
Las piezas de un sistema RAG
Un chatbot con RAG suele tener seis componentes:
- Documentos: políticas, catálogos, preguntas frecuentes, manuales y procedimientos, con fecha y responsable.
- Fragmentación (chunking): división de cada documento en partes de tamaño manejable, para que la recuperación encuentre el pasaje correcto.
- Embeddings: representaciones numéricas de los fragmentos que permiten comparar significados, no solo palabras exactas.
- Base vectorial o índice: almacén donde se guardan esos embeddings junto con su texto, su fuente y sus permisos.
- Recuperación: búsqueda de los fragmentos más relevantes para la pregunta del usuario.
- Generación: el modelo de lenguaje redacta la respuesta usando los fragmentos como contexto.
Una falla en cualquiera de estas piezas afecta la respuesta final. Un documento desactualizado o un fragmento mal cortado pueden producir una respuesta incorrecta aunque el modelo funcione bien.
Flujo paso a paso
La siguiente figura muestra cómo se procesa una pregunta desde que llega hasta que el usuario recibe la respuesta con su fuente.
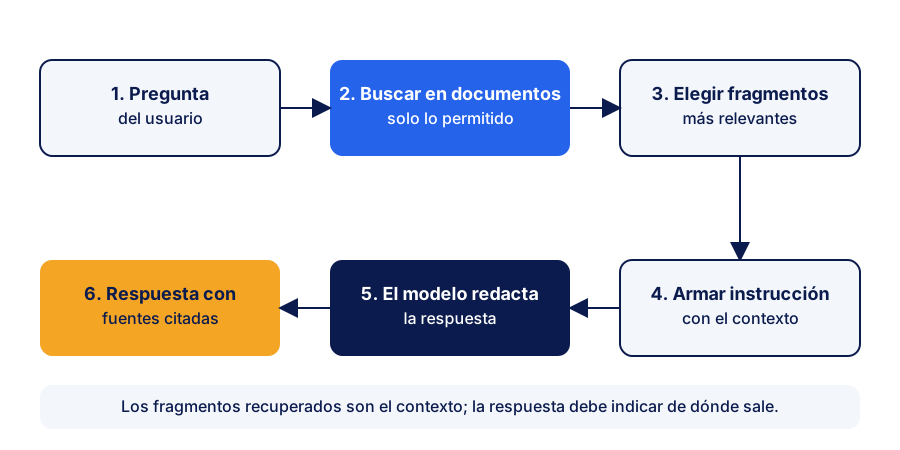
Figura 1. Flujo RAG: el modelo redacta solo con los fragmentos recuperados, y la respuesta debe indicar de dónde proviene.
¿Por qué RAG reduce las alucinaciones sin eliminarlas?
Un modelo de lenguaje genera texto según probabilidades. Sin contexto, puede completar una respuesta con algo que suena correcto. Con RAG, el modelo recibe pasajes concretos y tiene una base para responder, lo que suele mejorar la precisión frente a un modelo sin acceso a la empresa.
Sin embargo, RAG no garantiza la verdad. El sistema puede recuperar un fragmento irrelevante, interpretarlo mal, mezclar dos documentos contradictorios o responder algo aunque el documento no contenga la información. El marco NIST AI 600-1, publicado en 2024 como perfil de IA generativa del AI Risk Management Framework, incluye la confabulación entre los riesgos propios o agravados por la IA generativa. Por eso, la respuesta correcta a una pregunta sin respaldo debe ser admitir que no hay información, y transferir la consulta a una persona.
Qué datos prepara una empresa
Antes de conectar el chatbot, conviene preparar el contenido. Una lista práctica incluye:
- Documentos vigentes: elimina versiones antiguas y deja una sola fuente oficial por tema. Si el contenido vive en varios sistemas, conviene primero revisar la integración de sistemas.
- Responsable y fecha: cada documento debe indicar quién lo aprueba y cuándo se revisó.
- Preguntas frecuentes aprobadas: respuestas redactadas por el área responsable, no por el chatbot.
- Clasificación de confidencialidad: separa lo público, lo interno y lo restringido.
- Datos personales: no incluyas expedientes de clientes ni datos de empleados sin una evaluación previa. Si se trata de información de personas, revisa las obligaciones de la Ley de protección de datos personales en el Perú.
Un contenido bien ordenado mejora la recuperación más que cambiar de modelo. Muchas fallas que parecen del modelo son, en realidad, documentos duplicados o contradictorios.
Seguridad y permisos: que el bot no muestre datos a quien no corresponde
El riesgo más serio de un chatbot empresarial no es que se equivoque, sino que muestre información a una persona que no debía verla. Si el índice contiene contratos, precios internos y datos de clientes, y el bot los recupera para cualquier usuario, la fuga ocurre aunque la interfaz esté oculta.
La solución debe ser técnica. La documentación de Microsoft sobre RAG indica que, al usar Azure AI Search como fuente de datos, es posible aplicar control de acceso a nivel de documento mediante filtros de seguridad. El principio general es el mismo en cualquier plataforma: cada fragmento debe guardar sus etiquetas de acceso, y la búsqueda debe filtrar por la identidad y el rol del usuario antes de que el modelo reciba nada.
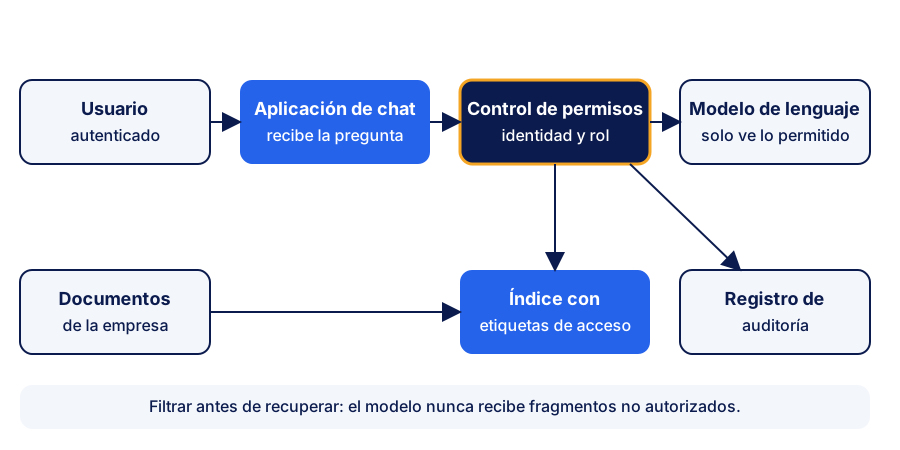
Figura 2. Control de permisos en un chatbot RAG: el filtro ocurre durante la recuperación, y cada consulta queda registrada.
OWASP, en su lista de riesgos para aplicaciones con modelos de lenguaje, incluye la divulgación de información sensible y la inyección de instrucciones (prompt injection). Un documento o una pregunta maliciosa puede intentar que el modelo ignore sus reglas o revele contenido que no debe mostrar. Por eso, el filtrado de permisos no debe depender solo de instrucciones dentro del prompt.
Chatbot por reglas, con IA generativa o con RAG
No todos los chatbots son iguales. La siguiente tabla compara los tres enfoques más comunes.
| Criterio | Chatbot por reglas | Chatbot con IA generativa | Chatbot con RAG |
|---|---|---|---|
| Cómo responde | Con flujos y respuestas predefinidas | Con texto generado por un modelo | Con texto generado a partir de documentos recuperados |
| Flexibilidad del lenguaje | Baja | Alta | Alta |
| Conocimiento de tu empresa | El que se programa a mano | Limitado al entrenamiento general | El de los documentos conectados |
| Riesgo de inventar respuestas | Bajo, pero responde poco | Medio o alto sin controles | Medio, reducido con fuentes y evaluación |
| Mantenimiento | Actualizar cada regla | Revisar el comportamiento del modelo | Mantener documentos, índice y permisos |
| Criterio de la comparación | Elaboración propia a partir de la arquitectura descrita | Elaboración propia | Documentación de Microsoft y artículo de Lewis et al. |
Para preguntas cerradas y repetitivas, como el horario o la forma de pago, un flujo por reglas puede bastar. Para consultas abiertas sobre documentos extensos, RAG suele ser la opción adecuada.
Riesgos y mitigaciones
La siguiente tabla resume los riesgos más frecuentes en un chatbot RAG y las medidas de control que conviene aplicar.
| Riesgo | Qué puede pasar | Mitigación |
|---|---|---|
| Fuga por permisos | Un usuario ve información de otra área | Filtrar por identidad y rol antes de recuperar |
| Inyección de instrucciones | Un texto manipula la respuesta o revela datos | Tratar el contenido recuperado como dato, no como instrucción; limitar herramientas |
| Documento desactualizado | El bot responde con una política vencida | Responsable, fecha de revisión y retiro de versiones antiguas |
| Datos personales en el índice | Se expone información de clientes o empleados | Excluir datos personales no necesarios y aplicar controles de acceso |
| Respuesta sin respaldo | El bot afirma algo que no está en los documentos | Exigir cita de fuente y derivar a una persona cuando no haya evidencia |
| Costo sin control | El consumo crece sin medirse | Límites de uso, monitoreo y revisión mensual |
Cada mitigación debe tener un responsable. Sin un responsable, las medidas técnicas se degradan con el tiempo.
Cómo medir la calidad
Un chatbot no debe publicarse solo porque responde con fluidez. La calidad se mide con un conjunto de preguntas reales, tomadas de correos, llamadas o chats de clientes, y con respuestas esperadas revisadas por el área responsable. Conviene evaluar al menos estos aspectos:
- Exactitud: la respuesta coincide con el documento oficial.
- Cita: el bot indica el documento o sección de donde sale la respuesta.
- Rechazo correcto: cuando la información no existe, el bot lo dice y ofrece derivar la consulta.
- Permisos: un usuario sin acceso no recibe fragmentos restringidos. Esta prueba debe hacerse con cuentas de prueba de cada perfil.
- Escalamiento: las consultas sensibles pasan a una persona con un resumen de la conversación.
La evaluación no es un evento único. Cada cambio en documentos, modelo o configuración puede alterar los resultados, por lo que conviene repetir las pruebas antes de cada actualización importante.
Costos como estructura
El costo de un chatbot RAG tiene varias partes:
- Preparación de documentos: ordenar, limpiar y revisar el contenido, que suele ser el trabajo más largo.
- Índice y búsqueda: almacenamiento de los fragmentos y su consulta.
- Consumo del modelo: cada pregunta y cada respuesta generan uso, que se factura según la tarifa vigente del proveedor.
- Integración y seguridad: conexión con el sitio web o WhatsApp, autenticación y registro de auditoría. Estas conexiones suelen apoyarse en APIs y webhooks.
- Mantenimiento: actualizar contenido, revisar conversaciones y repetir las evaluaciones.
No hay datos públicos verificados para Perú sobre precios de estos servicios en soles. Lo prudente es pedir una propuesta con supuestos claros: volumen mensual de consultas, cantidad de documentos y canales de atención.
Límites de un chatbot con RAG
Un chatbot con RAG tiene límites que conviene aceptar desde el inicio:
- No entiende bien documentos escaneados de mala calidad o tablas complejas si no se preparan antes.
- No reemplaza el criterio de un asesor en temas legales, tributarios o médicos.
- Depende de que el contenido esté actualizado; un cambio de tarifa sin actualizar el índice produce respuestas erradas.
- Puede tardar en responder si la búsqueda es amplia o si el modelo se consulta muchas veces.
Para ver cómo se combinan estos sistemas con otras capacidades de IA en la empresa, revisa el artículo sobre agentes de IA para empresas y cómo aplicarlos en una pyme, y el de IA generativa en la empresa: casos de uso, riesgos y políticas, que trata las reglas internas de uso.
Errores comunes
- Cargar todos los documentos sin revisarlos. Un índice con versiones contradictorias produce respuestas contradictorias.
- Aplicar permisos solo en la interfaz. Si el índice no filtra, el riesgo sigue existiendo.
- No definir qué hacer cuando no hay respuesta. El bot debe saber derivar, no improvisar.
- Publicar sin evaluación con preguntas reales. La prueba de demostración no refleja las consultas de los clientes.
- Olvidar el mantenimiento. Un contenido que no se actualiza vuelve inútil al chatbot en pocos meses.
- Tratar el chatbot como un proyecto cerrado. Necesita un responsable permanente.
Preguntas frecuentes
¿Qué es un chatbot con inteligencia artificial basado en RAG?
Es un asistente que busca primero en documentos de la empresa y luego genera una respuesta usando esos fragmentos. Así responde con información propia sin necesidad de reentrenar el modelo.
¿Cuánto cuesta un chatbot con RAG en Perú?
No hay datos públicos verificados para Perú sobre precios en soles. El costo depende de la cantidad de documentos, del volumen de consultas, de las integraciones y del mantenimiento, por lo que conviene pedir una propuesta con supuestos explícitos.
¿Qué diferencia hay entre RAG y entrenar un modelo con mis datos?
RAG consulta documentos en el momento de responder y permite actualizarlos sin reentrenar. Entrenar o ajustar un modelo cambia su comportamiento de forma más costosa y menos fácil de auditar.
¿Cómo evito que el chatbot muestre datos confidenciales?
Etiqueta cada documento con sus permisos y aplica el filtro durante la recuperación, según la identidad y el rol del usuario. No confíes solo en instrucciones escritas en el prompt.
¿Un chatbot con RAG elimina las respuestas incorrectas?
No. Reduce el riesgo, pero puede recuperar fragmentos irrelevantes o interpretarlos mal. Por eso la respuesta debe citar su fuente y el sistema debe derivar las consultas sin respaldo.
¿Cómo sé si el chatbot responde bien?
Pruébalo con preguntas reales de clientes y compara cada respuesta con el documento oficial. Revisa también que los usuarios sin permiso no reciban información restringida.
¿Qué documentos debo preparar primero?
Empieza por los que generan más consultas repetidas: horarios, condiciones, tarifas, políticas y preguntas frecuentes. Asigna a cada uno un responsable y una fecha de revisión antes de conectarlos.
Glosario rápido
RAG: generación aumentada por recuperación; el modelo consulta documentos antes de responder.
Embedding: representación numérica de un texto que permite comparar significados.
Base vectorial: almacén que guarda embeddings junto con su texto, fuente y permisos.
Fragmentación (chunking): división de documentos en partes para su recuperación.
Alucinación: respuesta generada con apariencia de certeza pero sin respaldo en los datos.
Prompt injection: texto diseñado para manipular el comportamiento del modelo.
Control de acceso: reglas que determinan qué información puede ver cada usuario.
Escalamiento: derivación de una consulta a una persona.
Si tu empresa quiere evaluar un asistente con sus propios documentos y permisos, puedes escribirnos desde la página de contacto. Para integrarlo con sus sistemas y datos, revisa nuestro servicio de plataformas.
Última revisión: 14 de noviembre de 2026.
Fuentes y lecturas recomendadas
- Lewis, P. y otros, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv, 2020. https://arxiv.org/abs/2005.11401
- Microsoft Learn, Retrieval Augmented Generation (RAG) in Azure AI Search. https://learn.microsoft.com/azure/search/retrieval-augmented-generation-overview
- Microsoft Learn, Retrieval augmented generation (concepto en Microsoft Foundry), donde se describe el control de acceso a nivel de documento con filtros de seguridad. https://learn.microsoft.com/azure/foundry/concepts/retrieval-augmented-generation
- National Institute of Standards and Technology (NIST), Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1), 2024. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
- OWASP, Top 10 for Large Language Model Applications. https://owasp.org/www-project-top-10-for-large-language-model-applications/
Desarrollo de software a medida
Plataformas web y apps que digitalizan y automatizan procesos de tu empresa.